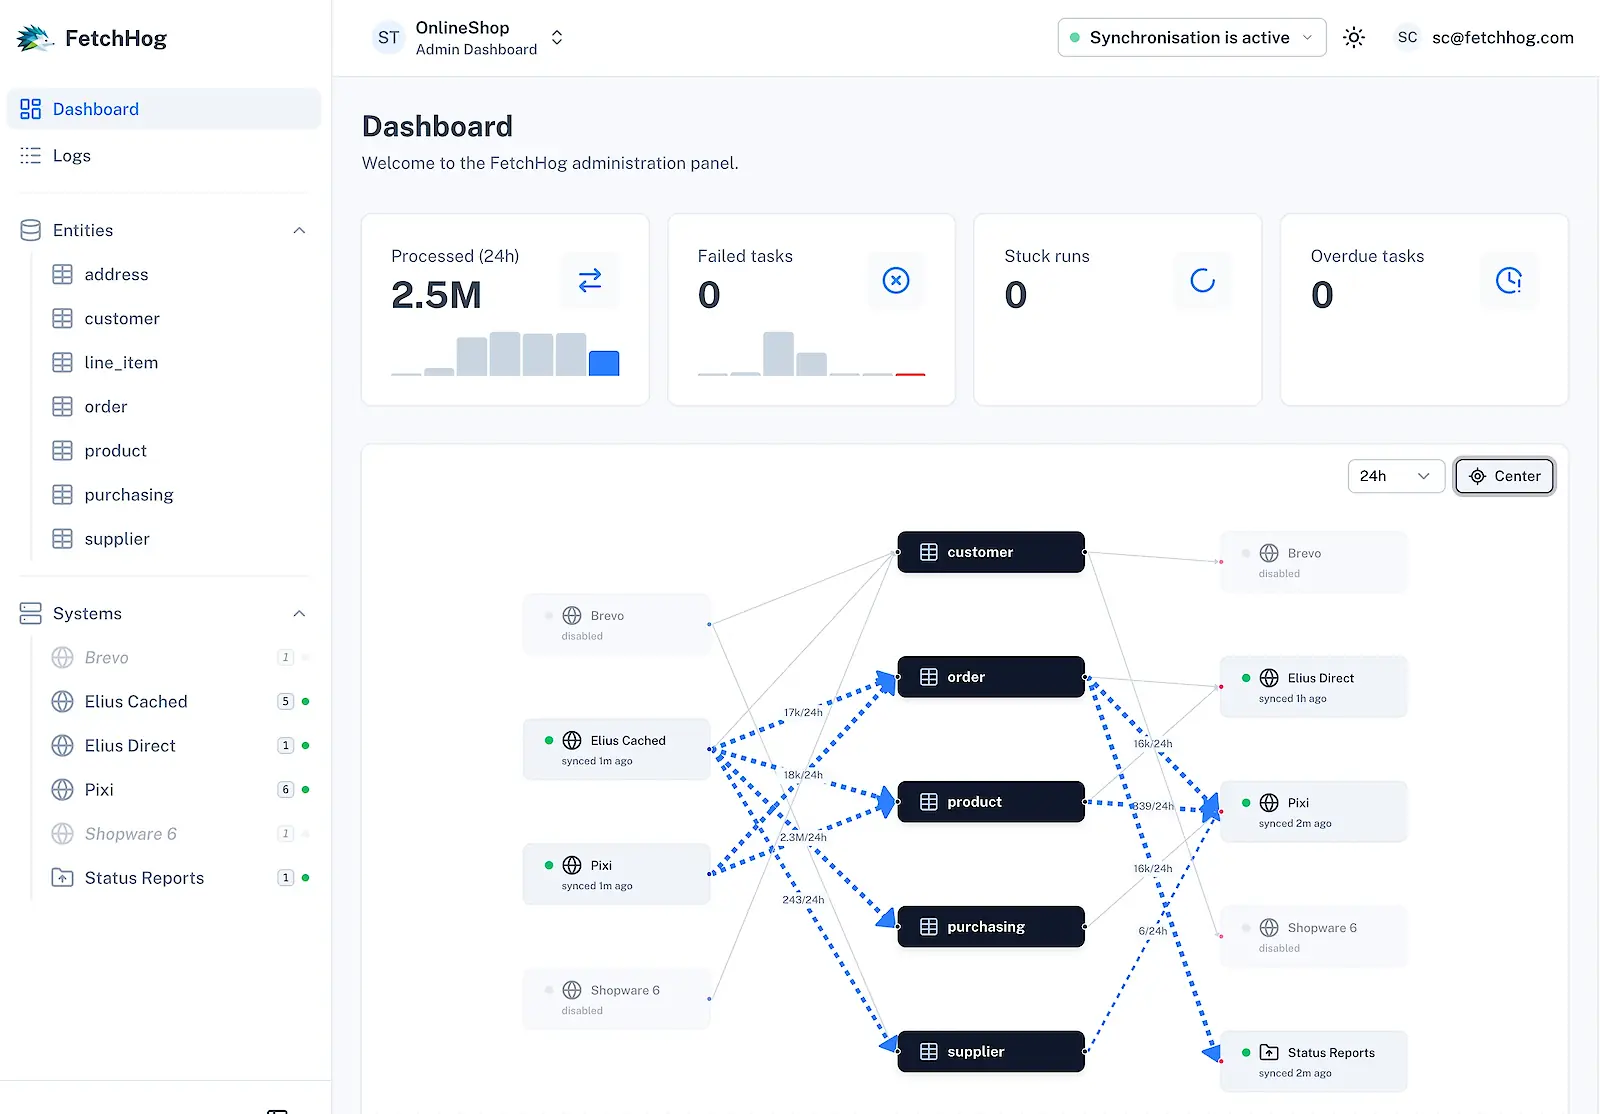
So funktioniert FetchHog Datenflüsse zentral konfigurieren, steuern und nachvollziehen.
Das Grundprinzip
Vier Bausteine für kontrollierte Datenflüsse.
FetchHog trennt angebundene Systeme, gemeinsame Datenstrukturen, Transformationen und Synchronisationslogik voneinander. Dadurch lassen sich Integrationen übersichtlich aufbauen, verändern und erweitern.
Systeme
Quellen und Ziele anbinden und ihre Zugriffe zentral konfigurieren.
Entities
Festlegen, welche Datenstrukturen wie Kunden, Produkte, Aufträge oder individuelle Datentypen verarbeitet werden.
Mappings
Daten aus unterschiedlichen Strukturen in das benötigte Format überführen.
Sync-Tasks
Definieren, welche Daten gelesen, verarbeitet und an welche Systeme übertragen werden.
Anbindungen
Quellen und Ziele zentral verwalten.
Jede externe Anwendung oder Datenquelle wird in FetchHog als System angebunden. Dabei wird zentral festgelegt, wie FetchHog auf das jeweilige System zugreift und wie Daten gelesen oder geschrieben werden können.
So bleibt die technische Anbindung von der eigentlichen Synchronisationslogik getrennt. Ändert sich ein System oder wird ein neues ergänzt, müssen bestehende Datenflüsse nicht vollständig neu gedacht werden.
- Systeme einmalig anbinden und zentral verwalten
- Verbindungen flexibel als Quelle oder Ziel einsetzen
- Neue Datenflüsse auf bestehenden Anbindungen aufbauen
Datenmodell
Eine gemeinsame Struktur zwischen unterschiedlichen Systemen.
Dasselbe Objekt kann in verschiedenen Anwendungen völlig unterschiedlich aufgebaut sein. Ein Kunde kann im CRM andere Felder besitzen als im ERP, obwohl beide Systeme dieselbe Person beschreiben.
FetchHog bildet solche Informationen in gemeinsamen Entities ab. Eine Entity definiert, welche Struktur innerhalb von FetchHog verwendet wird, zum Beispiel für Kunden, Produkte, Bestellungen oder individuell definierte Datentypen.
Dadurch müssen angebundene Systeme nicht dieselbe Datenstruktur verwenden.
Transformation Daten nicht nur zuordnen, sondern gezielt transformieren.
Zwischen zwei Systemen reicht eine einfache Feldzuordnung oft nicht aus. Daten müssen kombiniert, umbenannt, gefiltert oder strukturell verändert werden.
FetchHog nutzt dafür JSONata. Damit lassen sich auch komplexere Transformationen direkt innerhalb des Datenflusses definieren.
Beispiele
- Felder umbenennen oder zusammenführen
- Werte berechnen und ergänzen
- Bedingungen anwenden
- verschachtelte Strukturen erzeugen
- Daten filtern oder reduzieren
- unterschiedliche Quellformate in ein Zielmodell überführen
Synchronisation Sie definieren, welche Daten wohin fließen.
Sync-Tasks bilden die eigentlichen Datenflüsse in FetchHog ab. Sie legen fest, aus welchem System Daten gelesen, wie sie verarbeitet und in welches Zielsystem sie geschrieben werden.
So können einzelne Integrationsschritte gezielt konfiguriert und miteinander kombiniert werden.
Durch getrennte eingehende und ausgehende Sync-Tasks lassen sich auch bidirektionale Datenflüsse aufbauen.
Quelle
Daten aus einem angebundenen System einlesen.
Entity
Die Daten einer definierten Struktur zuordnen.
Mapping
Die Daten für den nächsten Verarbeitungsschritt transformieren.
Ziel
Die aufbereiteten Informationen an das vorgesehene System übertragen.
Änderungserkennung
Nur synchronisieren, wenn sich wirklich etwas geändert hat.
FetchHog vergleicht eingehende Daten mit dem bereits bekannten Stand. Nur wenn eine relevante Änderung erkannt wird, muss diese an weitere Systeme übertragen werden.
Dadurch werden unnötige Schreibvorgänge vermieden und Datenflüsse bleiben kontrolliert.
Historie
Daten verändern sich. Ihre Historie bleibt erhalten.
FetchHog basiert auf Event Sourcing. Änderungen an Daten werden nicht einfach durch einen neuen Zustand ersetzt, sondern als einzelne Ereignisse nachvollziehbar gespeichert.
So lässt sich erkennen, wann sich Informationen verändert haben und wie ein Datensatz zu einem bestimmten Zeitpunkt aussah.
Nachvollziehbarkeit
Jeden Synchronisationsvorgang im Blick.
FetchHog protokolliert, was innerhalb eines Datenflusses passiert. Dadurch lässt sich nachvollziehen, welche Daten eingelesen, verarbeitet und an ein Zielsystem übertragen wurden.
Auch technische Details wie Requests, Responses und auftretende Fehler können direkt im jeweiligen Vorgang geprüft werden.

Konfiguration Integrationslogik dort verwalten, wo sie hingehört.
Systeme, Entities, Mappings und Sync-Tasks werden zentral in FetchHog konfiguriert und verwaltet.
Dadurch verteilt sich die Integrationslogik nicht über zahlreiche Skripte, Cronjobs und individuelle Einzellösungen. Stattdessen entsteht eine nachvollziehbare Struktur, in der Datenflüsse gezielt angepasst und erweitert werden können.
- Systeme zentral verwalten
- Datenmodelle definieren
- Sync-Tasks konfigurieren
- Logs und Vorgänge prüfen
FAQ
Was Sie über FetchHog wissen sollten
FetchHog arbeitet mit Entities. Sie bilden gemeinsame Datenstrukturen wie Kunden, Produkte oder Aufträge ab und können auch individuell definiert werden.
Mappings transformieren Daten zwischen unterschiedlichen Quell- und Zielstrukturen. Dafür verwendet FetchHog JSONata.
Ein Sync-Task beschreibt einen konkreten Synchronisationsschritt. Er legt fest, welche Daten gelesen, verarbeitet und an welches System übertragen werden.
Nein. FetchHog kann Änderungen erkennen und Schreibvorgänge nur dann ausführen, wenn sich relevante Daten tatsächlich verändert haben.
Ja. Synchronisationsvorgänge werden protokolliert. Je nach Anbindung lassen sich unter anderem Verarbeitungsschritte, Requests, Responses und Fehler nachvollziehen.
Änderungen werden als Ereignisse gespeichert. Dadurch bleibt nachvollziehbar, wie sich Daten im Laufe der Zeit verändert haben.
Lassen Sie uns über Ihre Systeme sprechen
Wenn fünf Systeme miteinander sprechen sollen, brauchen Sie nicht fünf neue Schnittstellen.
FetchHog schafft eine zentrale Verbindung zwischen Ihren Systemen und sorgt dafür, dass Daten dort ankommen, wo sie gebraucht werden.